Sophgo Qwen3-VL 子图导出与部署边界
Qwen3-VL 是同时处理文本、图像和视频的视觉语言模型。部署到算能设备时,除了语言模型权重,还需要视觉编码、位置编码、tokenizer/processor 和自回归生成状态共同配合。
TPU-MLIR 是面向算能 TPU 的模型编译工具链,负责将模型转换成目标设备可执行的 BModel。llm_convert.py 是其中针对受支持大模型的转换入口:读取 Hugging Face 格式的配置与权重,导出计算子图,调用后端编译,再合并模型和运行配置。它在 x86 编译环境中工作;最终推理由目标设备上的运行程序组织。
本文关注 BM1684X 与 SE8 的部署问题。该 SE8 环境由经以太网互联的独立 SoC 节点组成。需要同时回答两个问题:模型内部如何划分执行阶段,以及这些阶段能否映射到实际设备拓扑。理解前者有助于定位编译失败,但不会自动解决后者。
SDK、转换命令与配套例程的操作入口见 Sophgo 模型编译部署教程。本篇继续解释子图职责,以及多设备与跨节点执行需要满足的条件。
一、子图的执行阶段
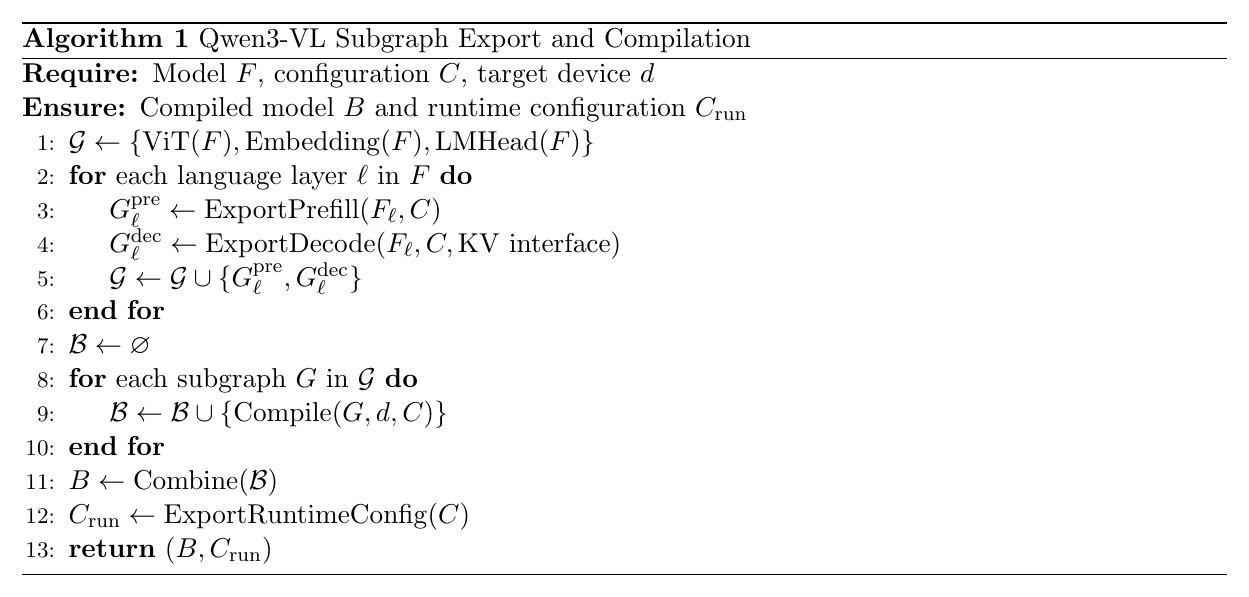
Qwen3-VL 按视觉模块、embedding、语言层和输出头组织子图。语言层通常分别生成 prefill 与 decode/cache 路径。“逐层拆分”描述图的组织方式,不能单独说明中间表示一定是 ONNX 或 MLIR。
算能大模型工具中存在两种转换流程,需按实际入口和版本区分:
| 路径 | 中间产物 | 主要步骤 |
|---|---|---|
| ONNX 导出示例 | block_i.onnx、block_cache_i.onnx 等 | PyTorch 子模块 → ONNX → model_transform.py → MLIR → BModel |
llm_convert.py 直接构图 | 子图 MLIR 与权重文件 | 配置与权重 → 转换器构建 MLIR → model_deploy.py → BModel |
llm_convert.py 的直接构图路径中,LlmConverter.gen_all_mlir() 逐层调用 gen_block_mlir(i);Qwen3VLConverter.gen_vit_mlir() 使用 MLIRImporter 构建视觉图,再写出 MLIR。这条路径按层构建图,不经过逐层 ONNX 中间文件。ONNX 导出示例则先导出子模块,再调用通用模型转换工具;两条路径的中间表示不同,后端都编译为 BModel。
排查实际环境时,应记录源码 commit、转换命令和生成目录。调用 torch.onnx.export、生成 .onnx 后再运行 model_transform.py,才是 ONNX 路径;直接创建 MLIR 算子与权重文件则是直接构图路径。不能只因二者最后都调用 model_deploy.py,就认为前端过程相同。
下面的算法省略采样头、DeepStack 专用操作和可选变体,突出导出、编译与打包的分工。
其中
Prefill 与 decode
Prefill 一次处理 prompt 中的多个 token,生成这些位置的 K/V;decode 通常每次处理一个新 token,读取历史 K/V,再追加当前位置结果。因此两条路径即使共享一层权重,也不适合默认使用完全相同的输入形状、缓存布局和调度方式。
| 阶段 | 典型输入 | 状态行为 | 子图示例 |
|---|---|---|---|
| 视觉编码 | 图像 patch、视觉位置 | 生成视觉特征 | vit |
| Prefill | 一段 prompt 的隐藏状态 | 产生该段输入的 K/V | block_i |
| Decode | 新 token、历史 K/V | 读取历史,写入新 K/V | block_cache_i |
流程图省略视觉特征插入、DeepStack 注入和位置编码细节,仅表示执行职责。运行程序仍需决定子图执行顺序、张量传递和缓存生命周期。model_tool --combine 合并模型文件后,这些运行接口依然存在。
子图与故障定位
模型部署至少有四个不同的失败位置:源模型加载、子图导出、后端编译和设备运行。如果已经生成 vit.mlir,随后在其后端编译中失败,继续检查模型下载或反复重装 transformers 通常无法缩小问题。
相反,保存失败子图、固定转换参数,再用独立编译命令复现,才能把一个大模型问题缩成可分析的编译问题。这是子图拆分除了执行效率之外的重要价值。
如果需要保留可切换 adapter 的低秩分支,编译预留与运行加载另见 Sophgo LoRA 编译预留与动态加载。
二、SE8 多设备编译
单 device 与 num_device=8 的编译对照结果如下。
| 配置 | 已记录结果 | 能确认的范围 |
|---|---|---|
| 32B AWQ,单 device,W4F16,seq=8192 | 生成 BModel | 编译产物生成,未证明设备加载和推理成功 |
32B AWQ,num_device=8 | 编译失败 | 该组合的多设备编译未跑通 |
8B,num_device=8 | 同样失败 | 不能仅用 32B 的参数量解释 |
| 调整视觉尺寸、group size、core 数 | 测试记录仍为失败 | 缺少逐组日志,不能形成严格单变量归因 |
保留下来的失败任务涉及视觉子图:
model_deploy.py --mlir vit.mlir --chip bm1684x --num_device 8 ...
  └─ tpuc-opt vit_bm1684x_f16_tpu.mlir ...
       ├─ 出现 position_ids / pos_idx 的 tpu.Cast 信息
       └─ Segmentation fault
日志支持将问题定位到该子图的后端编译任务,却不能直接证明某一条 Cast 是根因。整条命令包含多个 pass,必须通过更细日志、最小 IR 或调试栈确认崩溃位置。同样,段错误不等于已证明内存不足;这两类错误需要不同证据。
合理的后续实验是固定芯片、精度、输入上限及工具版本,先只改变 device 数;再独立改变视觉尺寸或编译并行度。否则多个参数一起变化,即使某次成功,也很难解释真正生效的条件。
三、容量与跨节点运行
节点容量
32B 参数按全部 4 bit 的理想情况粗算:
这只是权重的估算下界口径。真实峰值还包括量化元数据、保留高精度的模块、KV Cache 和工作区,视觉模块也可能采用不同精度。节点承载能力应比较实际可用内存与实测峰值,而不是模型文件大小或整台服务器的内存总量。
跨节点执行
独立 SoC 分别拥有自己的进程、内存与设备句柄。指定 num_device=8 不会自动建立跨主机通信,也不会将多个节点的内存合成一个连续设备空间。先确认运行程序实际看见哪些设备,再判断编译器生成的分片是否有可执行的通信与调度路径。
| 部署方式 | 单节点是否保存完整模型 | 主要解决的问题 | 需要的跨节点能力 |
|---|---|---|---|
| 多副本处理独立请求 | 是 | 提高请求吞吐 | 请求路由与结果返回 |
| 张量并行 | 否 | 分摊权重与层内计算 | 高频张量交换及同步 |
| 流水线并行 | 否 | 按阶段分摊容量与计算 | 阶段输出传递、流水线调度 |
副本并行不能解决单节点容量不足;模型分片能分摊容量,却需要转换器、运行时和互联共同支持。该环境的运行例程按本地设备句柄创建 BMRuntime,没有自动把另一台 SoC 纳入同一个推理实例。num_device 也不是节点发现或网络通信协议,编译成功不能替代跨节点执行实现。
普通以太网为何不适合细粒度张量并行
张量并行常在每层内部交换投影或归约结果。Prefill 的序列较长,激活传输量较大,更容易受到带宽限制;单路 decode 每次只生成一个 token,消息可能较小,但多层同步沿生成链串行发生,延迟和软件通信开销更难隐藏。每个节点拥有算力,并不意味着加入节点后单请求就会更快。
不考虑重叠的通信成本可用下式作初步估计:
其中
以 10 MB 数据的一次传输作理想估算,忽略协议、复制与同步:
| 链路速率 | 理论字节带宽 | 10 MB 单次传输时间 |
|---|---|---|
| 1 Gbit/s | 125 MB/s | 80 ms |
| 10 Gbit/s | 1.25 GB/s | 8 ms |
| 25 Gbit/s | 3.125 GB/s | 3.2 ms |
表中为理想传输时间,实际还包含协议、内存复制、同步和链路竞争,不能直接换算成模型的 token/s。普通低速以太网通常不适合以降低单请求延迟为目标的细粒度 TP;即使通信软件补齐,频繁跨节点同步也可能抵消新增算力的收益。
流水线并行减少层内归约,却需要阶段间传递与调度。单请求 decode 依次经过各阶段,不能简单把节点数换算成加速倍数;多请求或微批才能更充分利用流水线。高速以太网与 RDMA 可以支持其他集群的模型并行,因此不能把所有以太网一概判为不可用。
多副本处理独立请求只需传递请求与结果,对互联的要求通常低得多,更符合独立 SoC 的组织方式。小模型若能装入每个节点,可以通过请求路由提升总体吞吐;这仍然不能让一个容量不足的节点运行完整 32B 模型。
四、一些反思
SE8 上的 32B 部署同时受到单节点容量、多设备编译支持、跨 SoC 运行时和互联性能的约束。模型分片只能解决其中一部分问题,不能自动补齐通信与调度能力。
更有效的部署评估顺序是:先验证节点拓扑、运行时通信与互联预算,再确认各子图的编译支持范围,最后测量容量和端到端性能。跨节点执行缺失与互联性能不足是两个独立障碍:增加网络带宽不会自动得到分布式运行时,补上通信代码也无法消除细粒度同步的成本。
逐层导出同样不意味着模型已经具备分布式执行能力。子图可以帮助定位问题和定义接口,但把它放到远端还需要处理权重放置、激活传递、K/V 所有权和故障恢复。将“子图可拆”“模型可分片”“分布式可运行”“性能可接受”分别验收,才能避免从一种能力跳到另一种结论。
另一点是保留失败实验的证据粒度。记录“8B 也失败”比只记录“32B 报错”更有价值,因为它缩小了仅由参数规模解释问题的空间;但缺少固定版本和单变量对照时,仍不应把一种可能原因写成已确认根因。