Sophgo INT8 量化与精度调优
将 YOLOv5 的 ONNX 编译到 BM1684X 时,INT8 量化的主要工作是确定激活范围,并处理量化后出现的精度损失。权重可以从模型中直接读取,激活分布则依赖输入,需要用代表实际场景的数据运行模型,生成校准表。这属于训练后量化(PTQ),无需重新训练模型。
本文围绕 TPU-MLIR 的 INT8 路径展开:先对齐输入和校准范围,再定位误差,最后考虑让少量敏感层保留浮点。官方文档中的“全 INT8”仍允许编译器将部分算子保留为浮点,实际执行精度需要结合编译结果查看。
操作时会同时接触 calibration table 与 qtable。前者决定“浮点数映射到整数时使用多大的范围”,后者决定“哪些层采用什么精度”。两张表都影响最终结果,但不能互相替代。
| 产物 | 控制内容 | 主要问题 |
|---|---|---|
| 校准表 | 各张量的阈值与范围 | 截断和舍入之间怎样折中? |
| 混合精度表 | 层或张量的精度选择 | 哪些量化误差值得用浮点代价换回? |
TPU-MLIR 环境、浮点基线及板端运行的完整操作见 Sophgo 模型编译部署教程。
一、阈值与输入分布
以简化的有符号对称 INT8 为例,取浮点范围
KLD 比较量化前后的分布,MSE 方法关注重建误差,MAX 则保留最大绝对值对应的范围。检测模型中的少量大值可能承载关键预测信息,压低平均误差并不一定能保住这些预测。阈值选择需要回到实际输出上检查。
因此,校准前先对齐 RGB/BGR、resize/letterbox、padding、归一化和数据范围。如果校准阶段重复执行 /255,阈值搜索可能在自身数据上很好,却没有描述真实推理输入。
检测数据还需要覆盖目标大小、背景、光照和负样本。校准集的数量有用,但对部署分布的覆盖往往更值得先检查。
直接输入图片时,run_calibration 会依据 MLIR 中记录的参数做预处理;复杂预处理或多输入模型可以准备已处理的 NPY/NPZ。两条路径需要得到相同的输入张量,尤其要检查通道顺序、padding 值和归一化是否重复。
二、先建立 INT8 基线
对 YOLO 模型,官方文档建议先尝试默认 KLD 校准。初次量化尚不清楚哪种方法合适、又能接受更长校准时间时,可以使用 search_threshold 比较候选方法;已有稳定结果时,则直接固定校准方法,方便重复实验。
| 方式 | 解决的问题 | 使用时机 |
|---|---|---|
默认 KLD 或指定 cali_method | 用固定方法计算阈值 | 建立基线、复现实验 |
search_threshold | 比较候选方法,选择整网使用的校准方法 | 尚不清楚模型适合哪种方法 |
search_qtable | 逐层选择候选阈值,并搜索浮点层 | INT8 基线仍有明显精度损失 |
search_threshold 侧重选择校准方法,search_qtable 可以让不同层采用不同方法得到的阈值,并进一步调整执行精度。把这两步区分开,才容易判断改善来自阈值变化,还是来自浮点层增加。
以已经生成的 yolov5s.mlir 为例,默认校准的关键参数如下。100 张是示例规模,实际需要按场景覆盖调整:
run_calibration.py yolov5s.mlir \
  --dataset ./calibration_images \
  --input_num 100 \
  --processor bm1684x \
  -o yolov5s_cali_table
使用自动方法选择时,增加 --search search_threshold --inference_num 30;这里的 inference_num 控制方法比较所用的样本数量,与统计激活的 input_num 分工不同。所选工具版本的参数以 --help 为准。
校准结束后,还要检查是否生成了 qtable。TPU-MLIR 的 pattern-match 会识别部分 YOLO 结构,并将后处理、shape 或坐标计算中的一些算子列为不量化。这张表需要在部署时显式传入;模型改过结构或导出方式后,也应检查规则是否仍匹配、算子名称是否对应。
三、层敏感性与混合精度
一层的局部误差不等于它对最终结果的影响。在线性化理解下,某层扰动
只按单层 MSE 排序容易忽略误差对最终输出的影响。search_qtable 将候选阈值比较、层敏感性分析和完整混合模型验证串起来;下面给出默认 cosine 思路的概念流程。
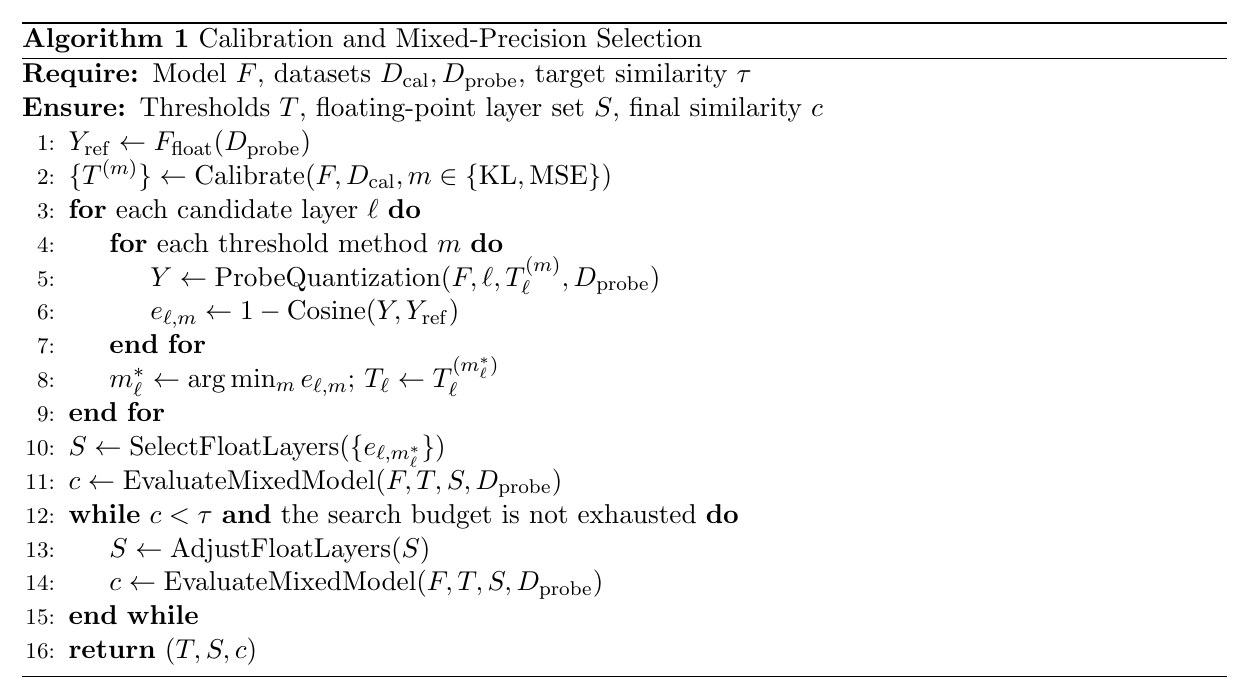
算法中
校准阈值与精度选择存在联系:某层“敏感”,可能部分来自阈值不合适。先比较阈值,再决定是否付出浮点成本,通常比一遇到掉点就把层改回 F16 更有解释力。
搜索样本可以有针对性地加入 INT8 基线表现较差的场景,用来定位误差;用于统计激活的校准集仍需保持代表性。最终评测使用独立数据,检查调整是否改善了整体表现。
search_qtable 会同时调整阈值和精度选择。按官方示例,搜索后的阈值写入 new_cali_table.txt,生成模型时需要将它与此次搜索得到的 qtable 配套使用:
model_deploy.py \
  --mlir yolov5s.mlir \
  --quantize INT8 \
  --processor bm1684x \
  --calibration_table new_cali_table.txt \
  --quantize_table yolov5s_qtable \
  --model yolov5s_int8_mix.bmodel
若沿用搜索前的校准表,即使传入了新的浮点层列表,也没有完整复现搜索时的配置。自动规则与搜索结果中的条目还需要一起核对,避免合并 qtable 时漏掉原本应保留高精度的算子。
四、输出相似度与任务精度
expected_cos=0.99 是搜索所用的输出相似度目标。浮点层数量还受到搜索上限约束,需要查看日志中最终达到的相似度和实际生成的 qtable。检测 mAP 则要另做任务评测。
检测模型存在阈值、排序和 NMS 等后处理:整体张量差异很小,仍可能改变少数临界框的保留结果。余弦适合搜索和定位,最终还要用实际框、类别、误检漏检和任务指标判断。
建议对 F16、全 INT8、混合 INT8 固定数据和运行条件,比较以下项目,而不是只保留一行 cosine:
| 维度 | 固定或记录内容 |
|---|---|
| 精度 | 同一评测集、前后处理、任务指标及关键场景误差 |
| 时延 | 同一输入大小、batch、预热与统计方式 |
| 精度配置 | 浮点层列表、校准表、工具版本 |
| 实际收益 | 端到端耗时、模型大小及精度转换开销 |
搜索数据与最终评测数据应有明确分工。反复在同一小批图片上选择阈值和浮点层,可能只优化这批数据;独立验证集用于检查选择是否能够迁移。
五、一些反思
混合精度是一种有成本的恢复手段。浮点层越来越多时,应先回头检查校准分布、导出接口和比较指标;否则输出可能恢复了,量化带来的速度和空间收益却消失了。
浮点层数量只能粗略描述混合精度的代价。一层大卷积和一层小规模坐标运算的成本差别很大,精度切换也可能引入转换开销。选择 qtable 时,既要知道哪些预测被恢复了,也要在设备上测量恢复这些预测花了多少时间。
量化调优更适合按输入、阈值、敏感层、任务指标的顺序推进。输入未对齐时换校准算法,或者检测头已经失真却只追求整网 cosine,都会让搜索结果难以解释。
校准表、qtable、数据划分和运行版本需要成组保留。只有这些条件一致,后续的精度变化才能被解释为一次具体修改的结果,而不是实验条件漂移。